
7주차: 신경망 기반 단어 임베딩, Word2Vec
신경망 기반 단어 임베딩, Word2Vec.
□ 이번 주에 하는 일
- 이웃 단어를 맞히는 연습으로 단어 벡터를 학습하는 Word2Vec을 본다. 연습 방식은 CBOW와 Skip-gram 두 가지다
- 네거티브 샘플링으로 연습을 가볍게 만드는 생각을 본다
- 직접 학습한 벡터와 큰 말뭉치로 미리 학습된 벡터에서 비슷한 단어를 찾고, 예상과 다른 결과가 왜 나오는지 말뭉치로 설명한다
조약돌이 색깔끼리 모여 있다. 새 조약돌을 어디에 둘지는 그 색이 정한다. 이번 주는 단어에 같은 일을 한다. 단어마다 자리를 정해 주되, 비슷한 단어가 가까이 놓이도록 자리를 학습한다.
□ 6주차에서 이어지는 자리
6주차에는 단어를 이웃과 함께 나온 횟수로 세어 동시발생 행렬을 만들고, 행을 단어 벡터로 썼다. 분포 가설, 즉 “이웃이 비슷하면 비슷한 단어”라는 생각은 이번 주에도 그대로다. 달라지는 것은 벡터를 만드는 방법이다.
| 6주차 동시발생 행렬 | 7주차 Word2Vec | |
|---|---|---|
| 벡터를 만드는 방법 | 이웃을 센다 | 이웃을 맞히는 연습을 되풀이한다 |
| 칸 수 | 단어 수만큼(42칸) | 우리가 정한다(노트북 20칸, 공개 벡터 300칸) |
| 0인 칸 | 대부분 0(희소) | 거의 없음(밀집) |
| 칸의 뜻 | 칸마다 이웃 단어 이름이 붙어 있다 | 칸 하나에는 정해진 뜻이 없다 |
6주차의 숙제도 이어진다. 희소한 벡터는 말뭉치가 작으면 우연에 크게 흔들렸다. 이번 주 후반에는 웹 문서로 미리 학습된 큰 벡터를 써서, 말뭉치가 크면 무엇이 좋아지고 무엇이 여전히 이상한지 본다.
□ 이 문서를 읽는 법
- 수식은 한 개도 나오지 않는다. 신경망 내부 구조는 개념도까지만 다룬다
- 직접 학습한 결과는 노트북과 같은 문장, 같은 설정으로 학습한 값이다. 학습용 문장은 틀에서 뽑은 설명용 예시다
- 미리 학습된 벡터의 결과는 노트북과 같은 공개 한국어 단어 벡터(fastText cc.ko.300, CC BY-SA 3.0)에서 계산한 실제 값이다. 소수 둘째 자리로 반올림했다
- 벡터 계산을 손으로 하지 않는다. 이번 주에 요구하는 것은 결과를 읽고 말뭉치로 이유를 설명하는 능력이다
온라인 (2시수)
Section titled “온라인 (2시수)”강의 1: 이웃을 맞히며 배우는 단어 벡터
Section titled “강의 1: 이웃을 맞히며 배우는 단어 벡터”□ 세는 대신 맞힌다
6주차에는 이웃을 세어 표를 만들었다. Word2Vec은 세지 않는다. 대신 빈칸 맞히기 연습을 아주 많이 한다.
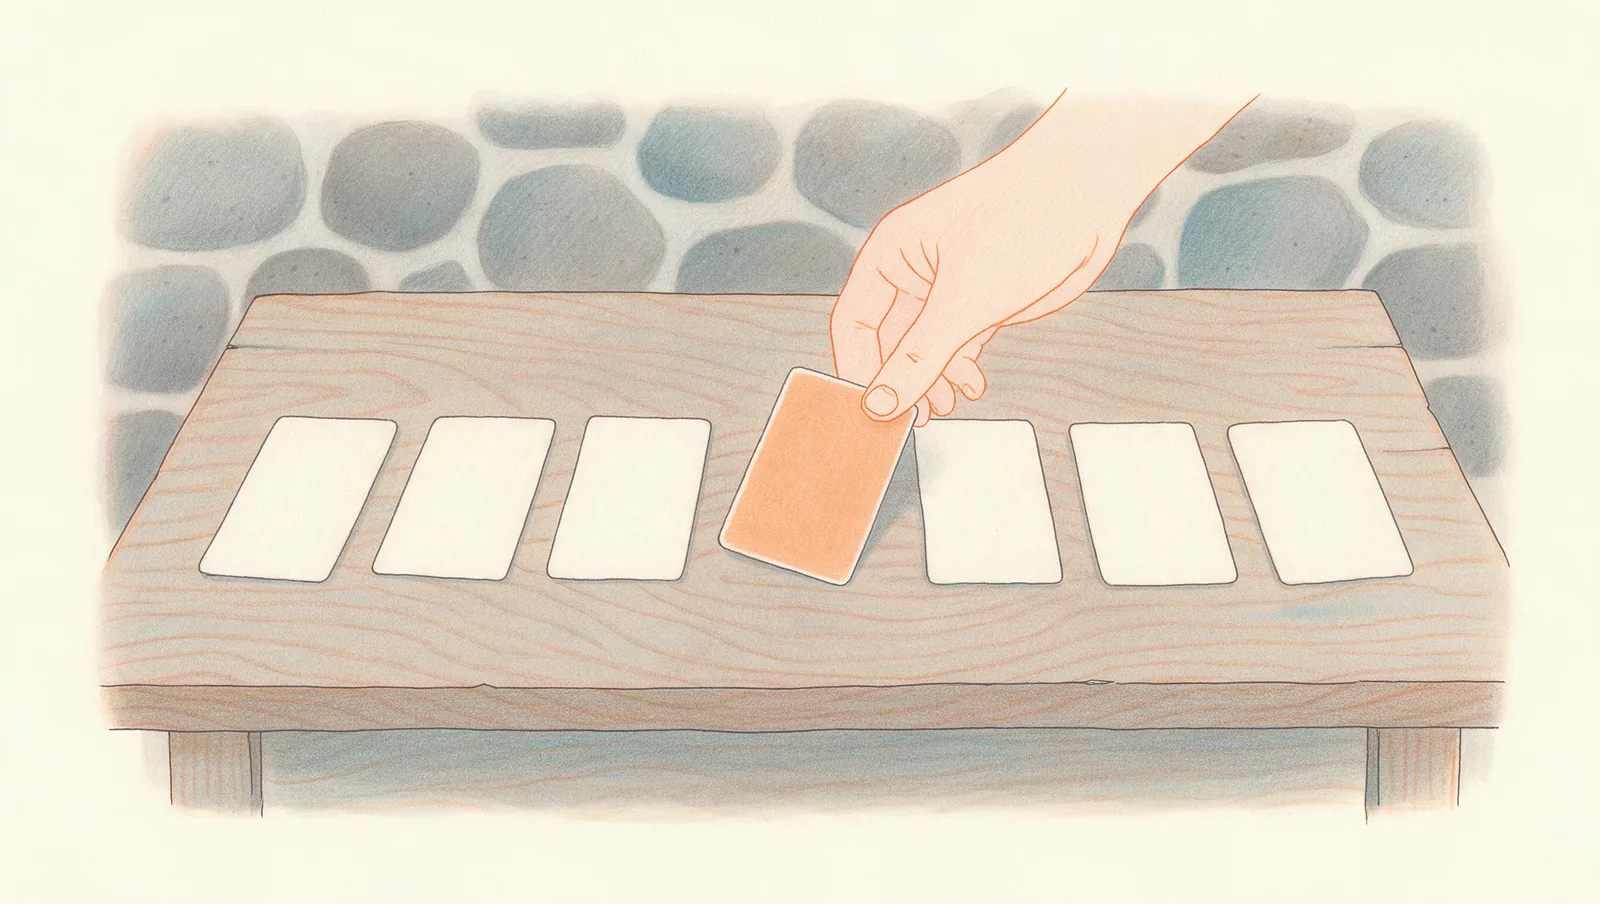
가운데 카드를 가리고, 양옆 카드만 보고 가운데 카드를 맞힌다고 하자. “애월 에서 ___ 를 먹었다”의 빈칸에는 고기국수 도, 갈치조림 도, 흑돼지 도 들어갈 수 있다. 이 연습을 수없이 하면 같은 빈칸에 들어가는 단어들이 비슷한 숫자를 갖게 된다. 그래야 같은 빈칸에서 함께 높은 점수를 받을 수 있기 때문이다.
결론은 6주차의 분포 가설과 같다. 이웃이 비슷한 단어끼리 벡터가 비슷해진다. 다만 세어서가 아니라 맞히는 연습의 결과로 그렇게 된다.
□ 두 가지 연습: CBOW와 Skip-gram
Word2Vec의 연습 방식은 두 가지다. 노트북의 학습 문장 하나로 보자.
단어를 눌러 가운데 단어를 바꾸고, 방식을 바꿔 보자.
| CBOW | Skip-gram | |
|---|---|---|
| 무엇으로 무엇을 맞히나 | 주변 단어 묶음으로 가운데 단어를 | 가운데 단어로 주변 단어를 하나씩 |
| 한 자리에서 만드는 문제 | 1개 | 이웃 수만큼(창 2면 최대 4개) |
| 흔히 알려진 장점 | 문제가 적어 학습이 빠르다 | 문제가 많아 드물게 나오는 단어도 연습을 많이 한다 |
노트북은 두 방식으로 모두 학습한다. 작은 말뭉치에서는 결과가 거의 같다. 고기국수 와 가장 비슷한 단어 셋은 두 방식 모두 흑돼지, 갈치조림, 전복죽 이다.
□ 신경망은 무엇을 하나: 개념도 수준으로
Word2Vec은 아주 작은 신경망이다. 내부를 수식 없이 그리면 이렇다.
- 단어마다 숫자 칸 목록을 하나씩 준다. 처음에는 아무렇게나 정한 숫자다
- 학습 문장에서 빈칸 문제를 하나 꺼낸다. 지금의 숫자로 답을 맞혀 본다
- 틀린 만큼 문제에 나온 단어들의 숫자를 조금씩 고친다
- 2와 3을 문장 전체에 걸쳐 여러 바퀴 되풀이한다
- 학습이 끝나면 단어마다 남은 숫자 목록이 그 단어의 벡터다
5주차 로지스틱 회귀의 “맞히고 고치기를 되풀이한다”와 같은 생각이다. 다른 점은 고치는 대상이 단어 점수 하나가 아니라 단어마다 숫자 목록 전체라는 것뿐이다. 노트북은 문장 1000개를 30바퀴(epochs=30) 돈다.
□ 네거티브 샘플링: 문제를 쉽게 바꾼다
빈칸 맞히기를 곧이곧대로 하면 모든 단어 중에서 정답 하나를 골라야 한다. 노트북의 작은 말뭉치는 단어가 28개라 괜찮지만, 미리 학습된 벡터는 단어가 200만 개다. 문제 하나마다 200만 개를 다 따지면 너무 느리다.
네거티브 샘플링은 문제를 바꾼다. “정답이 무엇인가” 대신 “이 짝이 진짜 이웃인가, 가짜인가” 를 묻는다.
- 진짜 이웃 짝 하나는 점수를 올린다. 창 2 안에서
고기국수의 이웃은애월,에서,를,먹었다넷이고, 그림은 그중먹었다와 맺은 짝을 보여 준다. 나머지 이웃도 각자 이런 문제를 하나씩 만든다 - 단어 목록에서 뽑아 온 가짜 짝 몇 개는 점수를 내린다. 노트북은 다섯 개를 뽑는다(
negative=5) - 가짜는 자주 나오는 단어일수록 더 자주 뽑는다. 실제 이웃도 무작위 가짜 후보로 뽑힐 수 있다. 이는 뜻이 무관하다는 정답표가 아니라, 정해진 분포에서 뽑아 대조하는 학습 절차다
한 문제에서 따지는 짝이 여섯 개뿐이라 단어가 200만 개여도 빠르다. 이 아이디어 덕분에 웹 문서처럼 큰 말뭉치로도 학습할 수 있다.
□ 밀집 벡터: 칸 수는 우리가 정한다
학습이 끝난 벡터를 6주차 행과 나란히 놓아 보자.
- 6주차
귤을의 행은 42칸 중 4칸만 0이 아니다. 칸마다 이웃 단어 이름이 붙어 있다 - 7주차
고기국수의 벡터는 20칸 모두 0이 아니다. 칸에는 이름이 없다
칸 하나에는 정해진 뜻이 없다. “3번째 칸은 음식 정도”처럼 읽을 수 없다. 숫자 전체가 가리키는 방향이 단어를 나타낸다. 비교는 6주차처럼 코사인 유사도로 한다.
이런 벡터를 밀집 벡터라고 부른다. 칸 수는 학습 전에 우리가 정한다. 노트북의 작은 모델은 20칸, 미리 학습된 공개 벡터는 300칸이다. 단어가 수만 개여도 칸은 수백 개라, 6주차처럼 단어 수만큼 긴 희소한 행보다 훨씬 짧다.
□ 학습할 때 정하는 것들
노트북 1-2에서 정하는 설정을 정리하면 이렇다.
| 설정 | 노트북 값 | 뜻 |
|---|---|---|
vector_size | 20 | 벡터의 칸 수 |
window | 2 | 이웃으로 볼 양옆 최대 칸 수. 학습 중에는 단어마다 1~2칸 사이에서 창을 무작위로 줄여 가까운 이웃을 더 자주 본다 |
sg | 1 또는 0 | 1이면 Skip-gram, 0이면 CBOW |
negative | 5 | 진짜 짝 하나마다 섞는 가짜 짝 수 |
epochs | 30 | 말뭉치 전체를 몇 바퀴 연습하나 |
min_count | 1 | 이보다 적게 나온 단어는 버린다 |
같은 결과가 매번 나오도록 노트북은 처음 숫자를 정하는 방식(seed 와 고정 해시)과 계산 순서(workers=1)를 고정해 두었다. 이것을 풀면 실행할 때마다 결과가 조금씩 달라진다. 학습이 무작위 숫자에서 출발하기 때문이다.
○ 작은 말뭉치의 결과 읽기
노트북 1-3의 작은 모델에서 고기국수 ~ 갈치조림 은 0.98, 고기국수 ~ 애월 은 0.68이다. 음식끼리 거의 1에 가까운 것은 학습 문장을 틀에서 뽑았기 때문이다. 음식 단어는 늘 같은 빈칸에 들어가니 숫자가 거의 같아진다. 1-4의 지도에서도 지명, 음식, 볼거리가 세 무리로 갈라진다. 진짜 글은 이렇게 깔끔하지 않다. 그래서 강의 2에서 웹 문서로 학습된 벡터를 본다.
□ 강의 1에서 꼭 가져갈 것
- Word2Vec은 이웃을 세지 않고 이웃 맞히기 연습을 되풀이해 벡터를 학습한다. 결론은 분포 가설과 같다
- CBOW는 주변으로 가운데를, Skip-gram은 가운데로 주변을 맞힌다
- 내부는 “맞혀 보고, 틀린 만큼 숫자를 고치기”의 반복이다. 5주차 학습과 같은 생각이다
- 네거티브 샘플링은 “정답 고르기”를 “진짜 짝인지 가짜 짝인지 가리기”로 바꿔 학습을 빠르게 한다
- 결과는 칸 수를 우리가 정한 밀집 벡터다. 칸 하나에는 뜻이 없고 숫자 전체의 방향이 단어를 나타낸다
강의 2: 미리 학습된 벡터로 보는 분산표현의 특성
Section titled “강의 2: 미리 학습된 벡터로 보는 분산표현의 특성”□ 미리 학습된 벡터
좋은 벡터를 얻으려면 큰 말뭉치와 긴 학습이 필요하다. 그래서 보통은 남이 큰 말뭉치로 미리 학습해 공개한 벡터를 가져다 쓴다. 노트북 1-5는 웹 문서로 학습된 공개 한국어 단어 벡터(fastText)를 쓴다. 단어 200만 개, 칸 300개다.
전부 받으면 너무 크다. 그래서 노트북은 자주 나오는 앞쪽 10만 단어만 받고, 그 뒤 60만 번째까지에서는 제주 단어 목록에 있는 것만 골라 담는다. 모두 100,018개다.
여기서 벌써 첫 번째 관찰이 나온다. 단어는 자주 나오는 순서로 놓여 있는데, 제주 향토 음식 이름은 아주 뒤에 있다. 고기국수 는 457,543번째, 갈치조림 은 519,108번째다. 몸국, 바당, 혼저 는 60만 번째 안에 없어 노트북이 벡터를 받지 못했다. 200만 단어 전체를 훑어 보면 몸국 은 1,170,703번째에 겨우 있고, 바당 과 혼저 는 아예 없다. 인사말 혼저옵서예 는 붙여 쓴 한 단어로 1,337,469번째에 있다. 이는 공개 벡터의 어휘 목록에서 확인한 위치·포함 여부다. 실제 학습 원문의 용례 빈도를 직접 센 결과와는 구분해야 한다.
□ 비슷한 단어 찾기
단어를 눌러 이웃을 보자. 결과는 네 갈래로 나뉜다.
| 갈래 | 단어 | 가장 비슷한 단어 | 읽는 법 |
|---|---|---|---|
| 잘 맞음 | 한라산 | 지리산, 설악산, 제주도, 태백산 | 같은 자리에 쓰이는 산 이름 |
| 잘 맞음 | 감귤 | 과일, 귤, 포도, 참외 | 과일끼리 |
| 여행 문맥 | 고기국수 | 갈치조림, 흑돼지, 전복죽, 옥돔 | 국수 종류가 아니라 제주 여행 음식 |
| 다른 뜻 | 하영 | 채영, 효린, 나연, 하은 | 제주어 “많이”가 아니라 사람 이름 |
| 다른 뜻 | 지슬 | 명량, 곡성, 영화, 옥자 | 제주어 “감자”가 아니라 영화 제목 |
| 다른 뜻 | 오름 | 암벽, 올레길, 올라, 솟아 | 제주의 오름보다 “오르다”의 뜻 |
| 받지 못함 | 몸국, 바당, 혼저 | 없음 | 몸국은 1,170,703번째라 노트북 범위 밖, 바당과 혼저는 200만 단어 전체에 없다 |
예상과 다른 이웃은 곧바로 계산 고장을 뜻하지 않는다. 결과에서 사람 이름·영화·여행 문맥과의 연결을 관찰할 수 있다. 하영 ~ 많이 는 0.17, 지슬 ~ 감자 는 0.34다. 이름과 영화 관련 용례의 영향은 가능한 설명이지만, 이 목록만으로 실제 학습 원문에서 어느 뜻이 더 자주 쓰였는지 확정할 수는 없다.
고기국수 도 눈여겨보자. 같은 국수인 칼국수 와는 0.46인데, 갈치조림 과는 0.68이다. 이는 음식 분류 체계보다 여행 문맥의 영향을 받았다는 해석과 맞는다. 정확한 원인 확인에는 학습 원문의 용례 대조가 필요하다.
□ 분산표현의 특성
이런 벡터를 분산표현이라고 부른다. 단어의 뜻이 한 칸에 담기지 않고 여러 칸의 숫자에 나뉘어 담기기 때문이다. 결과를 모아 보면 분산표현의 특성이 보인다.
- 같은 자리에 쓰이는 말끼리 가깝다.
한라산과지리산,감귤과포도처럼. 6주차 분포 가설이 말한 비슷함이다 - 서로 다른 범주도 가깝다.
남자~여자는 0.88이다. 서로 다른 범주가 비슷한 문맥에서 쓰이면 가깝게 표현될 수 있다. 이 값으로 두 범주가 같은 뜻이거나 서로 반대말이라고 결론내리지 않는다. 6주차의뜨겁다·차갑다같은 반대말은 별도로 점검할 대상이다 - 뜻이 여럿인 단어는 한 벡터에 섞인다. 단어 하나에 벡터가 하나뿐이라,
오름의 “화산”과 “오르기”가 한 자리에 뭉친다. 더 많이 쓰인 뜻 쪽으로 끌려간다 - 말뭉치에 드문 말은 자리가 없거나 아주 뒤로 밀린다.
바당,혼저는 200만 단어 어디에도 없고,몸국은 117만 번째쯤으로 아주 드물다. 드물게 나온 단어의 벡터는 몇 안 되는 문장에 따라 크게 흔들린다 - 조사와 어미가 붙은 모양이 따로 자리를 차지한다.
왕의 이웃에는왕인,왕의,왕이가,여왕의 이웃에는여왕이,여왕과가 먼저 나온다. 띄어쓰기로 자른 한국어의 숙제가 여기에도 남아 있다
□ 단어로 계산하기
벡터끼리 더하고 빼면 관계를 옮길 수 있다는 실험이 유명하다.
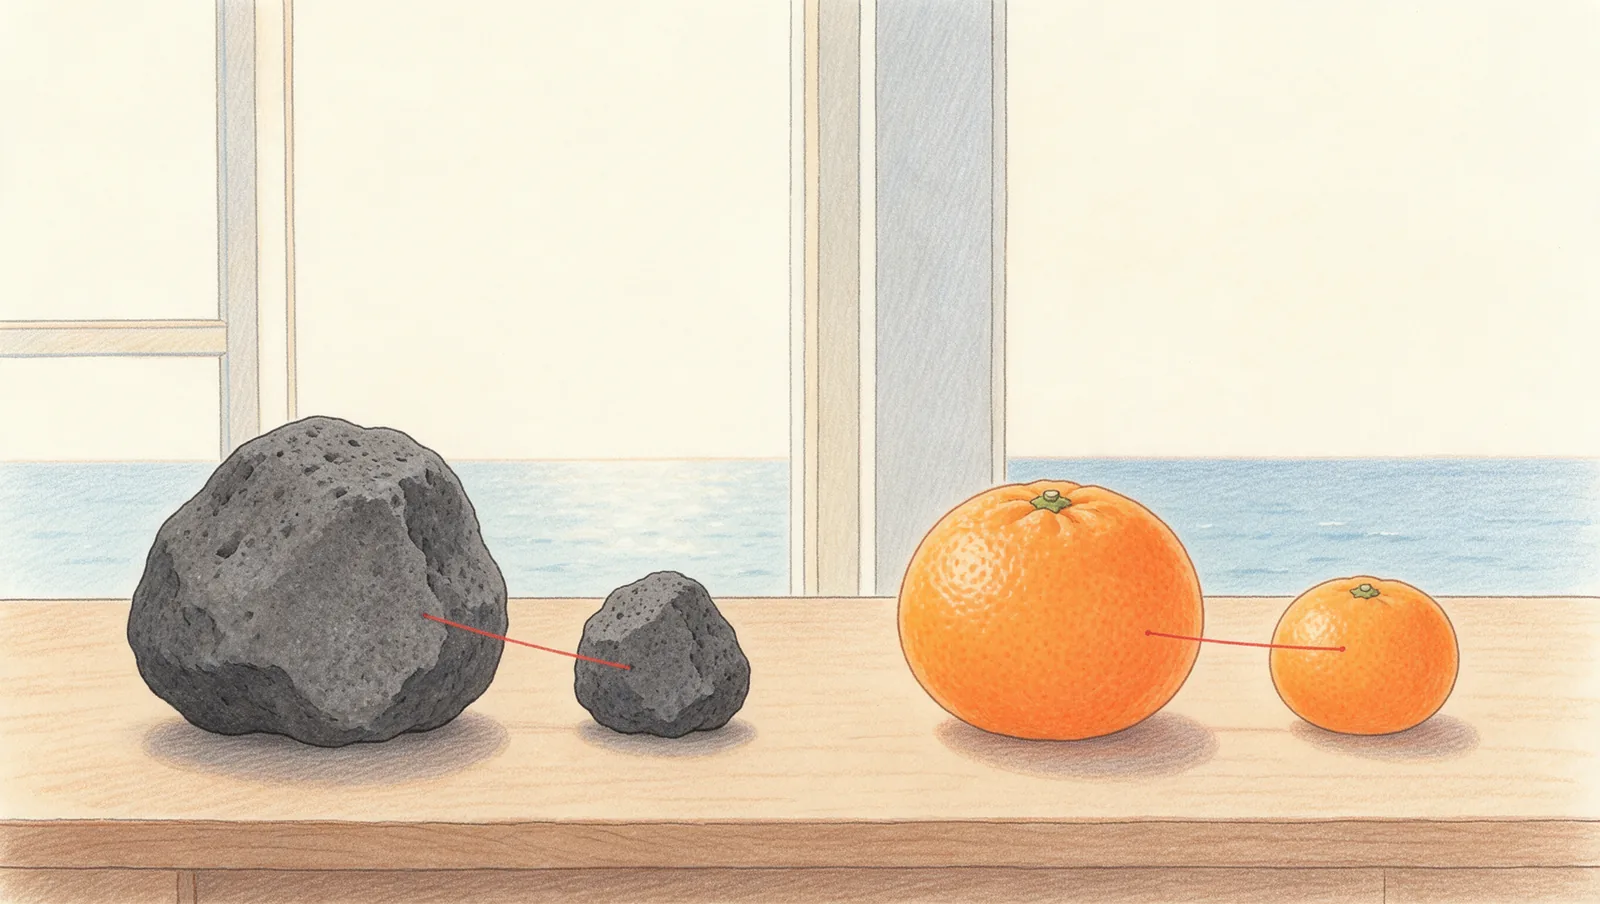
큰 돌에서 작은 돌로 가는 실과 큰 귤에서 작은 귤로 가는 실은 같은 관계, “큰 것에서 작은 것으로”를 나타낸다. 벡터에서도 같은 관계를 화살표로 옮길 수 있을까. 서울 + 일본 - 한국 은 “한국에서 일본으로 가는 화살표”를 서울에 옮기는 계산이다. 서울이 일본 쪽 짝인 도쿄에 닿으면 성공이다.
| 계산 | 기대 | 실제 1위 | 결과 |
|---|---|---|---|
| 서울 + 일본 - 한국 | 도쿄 | 도쿄 0.63 | 성공 |
| 도쿄 + 한국 - 일본 | 서울 | 서울 0.55 | 성공 |
| 왕 + 여자 - 남자 | 여왕 | 왕인 0.56 | 실패. 여왕은 19위 |
무엇을 관찰했고, 무엇은 아직 설명하지 못했는지 나누어 보자.
- 관찰: 나라·수도 계산은 기대한 단어가 1위, 성별·왕 계산은
왕인이 1위이며여왕은 19위 - 관찰:
남자~여자0.88,한국~일본0.68은 두 벡터 방향의 유사도, 관계 이동이 성공할 확률이 아님 - 가능한 설명: 왕의 조사 붙은 형태와 한자 표기가 상위 후보를 채워 기대한 답을 밀어낸 상황
- 미확인: 높은 유사도나 화살표 길이 하나가 실패의 원인이라는 주장. 정규화한 벡터에서는 유사도가 높을수록 차이 벡터가 짧지만, 길이뿐 아니라 방향과 후보들의 배치도 최종 순위에 영향
계산 결과는 입력한 세 단어(서울, 일본, 한국)를 빼고 고른다. 성공 사례만 보면 벡터가 관계를 “이해”하는 것 같지만, 실패 사례를 함께 보면 이웃의 분포가 허락하는 만큼만 통한다는 것을 알 수 있다.
□ 예상과 다른 유사어와 서비스
이 벡터를 추천이나 검색에 그대로 쓰면 무슨 일이 생길까.
고기국수를 검색한 사람에게 비슷한 말로갈치조림맛집을 보여 준다. 여행객에게는 도움이 될 수도 있지만, 국숫집을 찾는 사람에게는 엉뚱하다하영이 들어간 제주어 안내문을 비슷한 글로 묶으면, 사람 이름이 나오는 연예 기사가 섞여 든다바당,혼저처럼 벡터가 아예 없는 지역어는 비슷한 말 찾기에서 빠진다.몸국처럼 아주 드문 말도, 노트북처럼 자주 나오는 단어만 골라 쓰면 함께 빠진다. 드문 지역어일수록 서비스에서 보이지 않게 된다
벡터는 말뭉치를 비추는 거울이다. 지역 서비스를 만든다면 지역 글이 충분히 들어간 말뭉치로 다시 학습하거나, 이런 사례를 따로 점검해야 한다.
□ 왜 지금 이것을 배우는가
- 단어를 밀집 벡터로 바꾸는 방법은 이후 모든 언어모델의 입구다. 큰 언어모델도 글을 받으면 가장 먼저 조각마다 벡터를 찾는다
- 8주차는 단어 대신 문장과 문서를 벡터로 바꿔 검색에 쓴다
- 이번 주 벡터는 단어 하나에 벡터 하나라
오름의 두 뜻을 가르지 못했다. 9~10주차의 트랜스포머와 사전학습 모델은 문맥에 따라 같은 단어에도 다른 벡터를 준다. 이번 주의 한계가 그 출발점이다
□ 강의 2에서 꼭 가져갈 것
- 보통은 큰 말뭉치로 미리 학습된 벡터를 가져다 쓴다. 노트북은 공개 한국어 벡터의 앞쪽 10만 단어와 제주 단어를 쓴다
- 이웃에서 학습 문맥의 영향을 추측할 수 있다.
하영은 사람 이름,지슬은 영화 제목 쪽으로 가지만 뜻별 용례 빈도를 확정한 것은 아니다 - 분산표현은 비슷한 문맥의 서로 다른 범주도 가깝게 둘 수 있고, 여러 뜻을 한 벡터에 섞으며, 받은 어휘 목록 밖의 말은 검색할 수 없다
- 단어 연산은 통하기도, 실패하기도 한다.
서울 + 일본 - 한국은 도쿄,왕 + 여자 - 남자는 여왕이 19위다 - 예상과 다른 유사어는 추천과 검색에서 그대로 문제가 된다. 지역 서비스는 지역 말뭉치와 점검이 필요하다
□ 활동: 예상과 다른 유사어 세 건 모으기
노트북의 TODO 셀에 단어를 넣어 미리 학습된 벡터에서 비슷한 단어를 찾는다. 예상과 다른 결과 세 건을 골라 아래 표를 채운다.
| 번호 | 검색한 단어 | 예상한 이웃 | 실제로 나온 이웃(상위 몇 개) | 왜 다를까 |
|---|---|---|---|---|
| 1 | ||||
| 2 | ||||
| 3 |
- 제주 지명, 향토 음식, 방언, 동음이의어(뜻이 여럿인 말)를 넣어 보면 찾기 쉽다
- 벡터가 없다고 나오는 단어도 한 건으로 쳐도 된다. 왜 없는지를 쓴다
- 정답이 있는 활동이 아니다. “왜 다를까” 칸에 말뭉치의 특성으로 이유를 추측했는지가 핵심이다
대면 (1시수)
Section titled “대면 (1시수)”노트북 돌려 보기
Section titled “노트북 돌려 보기”□ 노트북에서 하는 일
틀에서 뽑은 제주 여행 문장 1000개로 Word2Vec을 학습하고, 공개 한국어 벡터를 내려받아 비슷한 단어 찾기와 단어 계산을 한다. 손대지 않아도 끝까지 돌아가고, TODO는 검색할 단어를 바꾸는 한 곳뿐이다.
- 한글 그래프를 위해 공개 글꼴을 내려받는다 (0)
- 학습용 문장 1000개를 만든다. 단어 종류는 28개다 (1-1)
- Skip-gram과 CBOW로 학습하고
고기국수의 벡터를 본다. 20칸 모두 0이 아니다 (1-2) - 비슷한 단어를 찾는다. 두 방식의 결과를 나란히 본다 (1-3)
- 단어 지도를 그린다. 지명, 음식, 볼거리가 세 무리로 갈린다 (1-4)
- 공개 한국어 벡터를 내려받는다. 네트워크에 따라 수 분 걸리며, 3분 읽기 제한 초과나 연결 실패 시 unavailable 기록 (1-5)
- 미리 학습된 벡터로 비슷한 단어를 찾고 단어 계산을 한다 (1-6, 1-7)
- TODO에서 내가 고른 단어의 이웃 열 개를 본다 (2)
□ 출력 읽는 법
- 1-3.
애월의 이웃이 다른 지명으로,바다의 이웃이 다른 볼거리로 나오는지 본다. Skip-gram 목록에맛있다나의같은 말이 섞이는 것도 확인한다. 음식이나 볼거리 단어와 같은 이웃을 많이 나눠 갖는 말이라 비슷하게 학습되었다 - 1-4. 지도는 위아래나 좌우가 뒤집혀 나올 수 있다. 무리가 어떻게 모였는지만 본다. 20칸을 2칸으로 줄인 그림이라 거리가 정확하지 않다
- 1-5. “벡터가 없는 제주 단어” 목록에
몸국,바당,혼저가 나오는지 확인한다. 읽은 앞쪽 60만 행에서 찾지 못했다는 뜻이다 - TODO. 기본값
서귀포를 넣으면 1위부터제주,제주시,서귀포시,표선,제주도순으로 나온다.흑돼지같은 음식 이름이 10위 안에 섞여 드는 것도 본다
공개 벡터가 unavailable이면 이웃·유추·TODO 검색은 실제 결과 없이 생략. 직접 학습한 1-1~1-4의 결과는 유지하고, 오류와 미관찰 항목을 구분해 기록. 강의의 확인된 예시를 자신의 실행 결과로 제출하지 않는 원칙.
□ 자주 막히는 지점
| 증상 | 원인 | 조치 |
|---|---|---|
ModuleNotFoundError: No module named 'gensim' | 설치 셀을 건너뛰었거나 런타임이 끊겼다 | 설치 셀부터 다시 실행한다 |
1-5에서 URLError, HTTPError, TimeoutError, EOFError 같은 연결 오류 | 인터넷 연결이 끊겼거나 내려받기 제한에 도달했다. unavailable을 기록하고 실제 공개 벡터 결과는 생략 | 직접 학습 결과 관찰을 유지하고, 연결 복구 후 1-5부터 다시 실행한다 |
| 그래프의 한글이 네모로 나온다 | 글꼴 셀이 실패했다 | 글꼴 셀을 다시 실행한 뒤 그래프 셀을 다시 실행한다 |
NameError: name 'ko' is not defined | 1-5를 실행하지 않았거나 런타임이 다시 시작되었다. 다운로드 실패는 ko=None으로 구분 | 1-5부터 다시 실행한다 |
| “벡터가 없습니다”가 나온다 | 넣은 단어가 받아 온 단어 안에 없다 | 조사를 뗀 모양으로 넣거나 다른 단어를 넣는다 |
- 기본: 제공된 결과의 이웃 목록 한 건에서 예상과 관찰의 차이 설명
- 심화: 같은 TODO 한 곳에서 다른 단어를 비교하고, 관찰된 순위와 말뭉치 원인에 대한 가설 구분
[이론] 신경망 내부 구조는 개념도 수준까지만. “왕 - 남자 + 여자 = 여왕” 유형 연산을 한국어에서 시도하고 성패 원인 토론
- 강의 1의 “신경망은 무엇을 하나” 다섯 단계를 내 말로 한 줄씩 적는다
- 노트북 1-7의 두 계산 결과를 옮기고, 기대한 답의 순위와
왕의 다른 형태가 상위에 나온 관찰을 기록한다. 유사도 0.88 하나로 실패 원인을 확정할 수 없는 이유도 설명한다 - 다른 관계(나라와 수도, 계절과 과일 등)로 계산을 하나 더 만들어 보고 성패를 예상한다
- 계산 결과를 맞히는 것이 아니라, 관찰된 순위와 가능한 설명을 구분했는지로 채점한다
[구현] 임베딩을 데모 따라 학습시키고 유사어 검색·시각화
- 노트북을 처음부터 끝까지 실행하고 1-3의 비슷한 단어 목록과 1-4의 지도를 확인한다
- TODO 셀에서 단어 세 개를 넣어 이웃 열 개씩을 기록한다. 온라인 학습활동의 표에 옮긴다
- 코드가 돌지 않아도 무엇을 확인하려 했는지 쓰면 부분 점수를 받는다
[실무] 예상과 다른 유사어가 나온 이유를 말뭉치 특성으로 설명. 제주 지명·향토 음식 이름의 연관어가 이상하게 나오는 사례를 모아 추천·검색 서비스의 문제와 연결
- 강의 2의 표에서 한 사례를 골라, 그 이웃이 나온 이유를 “어떤 글에 쓰였나”로 설명한다
- 그 벡터로 관광 추천이나 검색을 만들면 누가 어떤 불편을 겪는지 한 문장으로 적는다
- 고칠 방법을 하나 제안한다. 지역 글로 다시 학습하기, 동음이의어 점검 목록 만들기, 벡터 없는 단어를 따로 처리하기 등
- 정답 방향이 아니라 원인과 영향을 연결했는지로 채점한다
자주 하는 오해 Q&A
Section titled “자주 하는 오해 Q&A”Q1. Word2Vec은 단어의 뜻을 이해하는가?
아니다. Word2Vec이 아는 것은 어떤 단어가 어떤 이웃과 함께 나왔는지뿐이다. 이웃 맞히기 연습을 잘하도록 숫자를 고친 결과, 비슷한 자리에 쓰이는 단어의 숫자가 비슷해졌을 뿐이다. 하영 이 사람 이름들과 모인 것은 학습 문맥의 영향을 보여 주는 관찰이다. 어떤 용례가 얼마나 기여했는지는 이웃 목록만으로 확정할 수 없다.
Q2. 6주차 동시발생 행렬과 결국 같은 것 아닌가?
출발점은 같다. 둘 다 “이웃이 비슷하면 비슷한 단어”라는 분포 가설을 따른다. 다른 점은 두 가지다. 6주차는 이웃을 세고, Word2Vec은 이웃을 맞히는 연습으로 숫자를 학습한다. 그리고 6주차 행은 단어 수만큼 길고 대부분 0이지만, Word2Vec 벡터는 칸 수를 우리가 정하고 거의 모든 칸에 숫자가 있다. 단어가 200만 개인 말뭉치라면 6주차 방식의 행은 200만 칸이 되지만, Word2Vec 벡터는 여전히 300칸이다.
Q3. CBOW와 Skip-gram 중 무엇이 더 좋은가?
정해진 답은 없다. 흔히 CBOW는 학습이 빠르고, Skip-gram은 드물게 나오는 단어에 강하다고 알려져 있다. 노트북의 작은 말뭉치에서는 두 방식의 결과가 거의 같았다. 자료와 목적에 맞춰 골라 쓰는 설정이다.
Q4. 왜 “왕 - 남자 + 여자”가 여왕을 찾지 못하는가?
확인한 것은 왕인, 국왕, 王 이 상위 후보에 있고 여왕 이 19위라는 결과다. 유사도 0.88은 방향의 가까움이며 실패 원인이나 관계 이동 성공률은 아니다. 관계 벡터의 방향, 출발점, 후보 배치, 검색 범위가 함께 영향을 준다. 조사가 붙은 모양과 한자 표기의 영향은 가능한 설명으로 남기며, 원인 하나를 확정하지 않는다.
Q5. 벡터가 없는 단어(바당)는 영영 쓸 수 없는가?
경우를 나눠야 한다. 몸국 처럼 200만 단어 안에는 있지만 노트북이 받지 않은 말은, 받는 범위를 넓히면 벡터를 얻는다. 다만 아주 드물어 벡터가 흔들린다. 바당 처럼 전체에 없는 말은 방법이 두 가지다. 첫째, 그 단어가 충분히 들어간 말뭉치로 다시 학습한다. 둘째, 단어를 글자 조각으로 나눠 조각마다 벡터를 학습하는 방식을 쓴다. fastText 원래 모델은 이 방식이라 처음 보는 단어도 조각 벡터를 모아 벡터를 만들 수 있다. 노트북은 완성된 단어 벡터만 받아 왔기 때문에 이 기능을 쓰지 않는다.
Q6. 300칸 중 한 칸은 무엇을 뜻하는가?
정해진 뜻이 없다. 학습은 칸마다 이름을 붙이지 않고, 이웃 맞히기를 잘하도록 숫자 전체를 고칠 뿐이다. 그래서 칸 하나를 떼어 읽는 것은 의미가 없고, 숫자 전체가 가리키는 방향을 다른 단어와 비교해야 한다. 6주차 행처럼 칸마다 이웃 이름이 붙은 벡터와 가장 다른 점이다.
Q7. 검색 목록 밖의 단어는 학습 원문에도 없다는 뜻인가?
아님. 이번 노트북은 앞쪽 10만 단어와 60만 번째까지의 제주 단어 일부만 검색. 그 밖의 단어는 전체 공개 벡터에 있더라도 후보에서 제외. 받은 어휘 범위에 없음, 전체 벡터에 없음, 학습 원문에 없음은 서로 다른 주장. 전체 벡터에 없는 표기라도 글자 조각을 사용하는 원래 fastText 모델은 별도로 표현 가능.
Q8. 단어 지도에서 가까우면 300칸 벡터도 반드시 가까운가?
보장 불가. 지도는 여러 칸을 2칸으로 줄인 그림이라 일부 거리 정보가 손실. 무리의 모양을 관찰하되 실제 유사도는 원래 벡터로 계산한 숫자 확인. 화면의 오른쪽·위쪽에 고정된 의미가 있는 것도 아님.
스스로 점검
Section titled “스스로 점검”- Word2Vec이 벡터를 만드는 방법을 6주차와 비교해 한 문장으로 말하라.
- CBOW와 Skip-gram은 각각 무엇으로 무엇을 맞히는가?
- 네거티브 샘플링은 어떤 문제를 어떤 문제로 바꾸는가? 왜 그렇게 하는가?
- 밀집 벡터의 칸 하나를 떼어 읽으면 안 되는 이유는?
하영의 이웃이 사람 이름으로 나온 이유를 말뭉치로 설명하라.- 나라·수도 계산과 왕 계산의 관찰 결과를 비교하라. 유사도 하나로 성패 원인을 확정할 수 없는 이유는?
정답 보기
-
6주차는 이웃을 세어 표를 만들고, Word2Vec은 이웃을 맞히는 연습을 되풀이하며 숫자를 학습한다. 둘 다 이웃이 비슷한 단어끼리 벡터가 비슷해진다.
-
CBOW는 주변 단어 묶음으로 가운데 단어를, Skip-gram은 가운데 단어로 주변 단어를 하나씩 맞힌다.
-
“모든 단어 중 정답 고르기”를 “이 짝이 진짜 이웃인지 가짜인지 가리기”로 바꾼다. 문제 하나에서 따지는 짝이 진짜 하나와 가짜 몇 개뿐이라, 단어가 200만 개여도 학습이 빠르다.
-
칸 하나에는 정해진 뜻이 없기 때문이다. 학습은 숫자 전체를 고칠 뿐 칸마다 이름을 붙이지 않는다. 단어는 숫자 전체가 가리키는 방향으로 나타나고, 비교도 방향(코사인 유사도)으로 한다.
-
이웃에 사람 이름이 모이고
많이와의 유사도는 0.17이라는 관찰이다. 이름 용례의 영향으로 해석할 수 있지만, 실제 학습 원문에서 두 뜻의 빈도를 직접 센 것은 아니므로 어느 뜻이 더 많이 쓰였는지 확정하지 않는다. -
확인한 것은 계산 결과와 후보 순위다. 나라·수도 계산은 기대한 단어가 1위, 왕 계산은
왕인이 1위이고여왕은 19위다. 높은 유사도 하나로 성패를 설명하지 않는다. 관계 방향·출발점·후보 배치의 영향은 함께 검토할 대상이다.
이번 주 용어 정리
Section titled “이번 주 용어 정리”| 용어 | 한 줄 뜻 |
|---|---|
| 단어 임베딩 | 단어를 숫자 목록(벡터)으로 나타낸 것. 비슷한 단어가 가까이 놓이도록 만든다 |
| Word2Vec | 이웃 단어를 맞히는 연습으로 단어 벡터를 학습하는 방법 |
| CBOW | 주변 단어 묶음으로 가운데 단어를 맞히는 Word2Vec 방식 |
| Skip-gram | 가운데 단어로 주변 단어를 하나씩 맞히는 Word2Vec 방식 |
| 네거티브 샘플링 | 진짜 이웃 짝과 뽑아 온 가짜 짝을 가리게 해 학습을 빠르게 하는 방법 |
| 밀집 벡터 | 칸 수를 정해 두고 거의 모든 칸에 숫자가 있는 벡터 |
| 분산표현 | 뜻이 한 칸이 아니라 여러 칸의 숫자에 나뉘어 담긴 표현 |
| 미리 학습된 벡터 | 큰 말뭉치로 남이 미리 학습해 공개한 단어 벡터 |
| 에포크 (epoch) | 학습 말뭉치 전체를 한 바퀴 연습한 단위 |
| 단어 연산 (유추) | 벡터를 더하고 빼서 관계를 옮겨 보는 실험. 서울 + 일본 - 한국 |
| 동음이의어 | 소리와 표기는 같고 뜻이 다른 말. 한 벡터에 뜻이 섞인다 |
이번 주 읽기
Section titled “이번 주 읽기”주교재 5장 Embeddings. 6주차와 7주차에 걸쳐 읽는다. 자세한 서지 정보는 강의계획서를 참고한다.
- 이 장은 수식이 많다. 수식이 나오는 부분은 넘어간다. 이 과목의 시험 범위가 아니다
- Word2Vec과 Skip-gram, 네거티브 샘플링을 소개하는 부분과, 비슷한 단어와 단어 연산(유추) 예시를 찾아 읽는다
- Gensim 벡터 검색 공식 문서:
most_similar의 계산과 입력 단어 제외 확인. 후보 순위와 성패 원인 구분 - 교재의 예시는 영어다. 영어 예시에서 잘 되는 단어 연산이 한국어 벡터에서는 왜 흔들렸는지, 이번 주에 본 조사 붙은 모양과 한자 표기로 떠올려 본다
실습 노트북
Section titled “실습 노트북”
틀에서 뽑은 제주 여행 문장으로 Word2Vec을 학습하고, 공개 한국어 벡터에서 제주 단어의 이웃을 찾는다. TODO는 검색할 단어를 바꾸는 한 곳이다.